10 - Langage assembleur
Razik Ikhlef
La mémoire dans le modèle de Von Neumann
Dans l’architecture de Von Neumann, une seule mémoire, la mémoire vive (RAM), reçoit à la fois les données et le programme, c’est-à-dire la suite des instructions à exécuter.
Or la mémoire ne contient que des bits. Prenons l’octet 01000001 :
- lu comme un entier, il vaut 65 ;
- lu comme un caractère codé en ASCII, c’est la lettre
A; - lu par le processeur comme une instruction, c’est un ordre, dont le sens dépend du processeur.
La mémoire dans le modèle de Von Neumann (suite)
Rien, dans l’octet lui-même, n’indique laquelle de ces lectures est la bonne. C’est l’usage qui décide : le processeur traite comme une instruction le mot rangé à l’adresse indiquée par son compteur de programme, et comme une donnée le mot qu’une instruction lui demande de lire. Le programmeur et le système d’exploitation doivent donc ranger instructions et données à des endroits bien séparés.
Les instructions machine
Principe
Une instruction machine est un mot binaire formé de deux parties :
code de l'opération | opérandes
- le code de l’opération (en anglais opcode) dit ce qu’il faut faire : additionner, copier, comparer… ;
- les opérandes disent sur quoi agir : un registre, une valeur, une adresse en mémoire.
Principe (suite)
Remarque : l’ensemble des opérations qu’un processeur sait exécuter s’appelle son jeu d’instructions. Chaque famille de processeurs a le sien : un programme en langage machine écrit pour un processeur ne fonctionne pas sur un autre.
Par exemple, pour un petit processeur imaginaire, l’instruction :
00110010 00001010
Principe (suite)
pourrait se lire ainsi :
- le premier octet
00110010est le code de l’opération « ajouter une valeur au registre R2 » ; - le second octet
00001010, soit 10 en décimal, est l’opérande : la valeur à ajouter.
Une instruction occupe un ou plusieurs mots de la mémoire. Le mot est la quantité d’information que le processeur traite d’un seul coup : 8 bits (un octet) pour un processeur 8 bits, 64 bits (huit octets) pour un processeur 64 bits comme ceux des ordinateurs actuels.
Principe (suite)
Les premiers programmeurs écrivaient directement ces suites de bits : c’est le langage machine, le seul que le processeur comprenne.
Opérations de base
Les jeux d’instructions diffèrent d’un processeur à l’autre, mais on y retrouve presque toujours les mêmes familles d’instructions :
Opérations de base (suite)
- transfert : placer un nombre dans un registre, copier un registre dans un autre, lire un mot de la mémoire vers un registre ou écrire un registre en mémoire ;
- calcul : additionner ou soustraire deux registres, appliquer une opération logique (ET, OU, OU exclusif) bit par bit, le résultat étant rangé dans un registre ;
- comparaison : comparer deux registres, ce qui positionne des indicateurs (résultat nul, négatif…) ;
- saut : poursuivre l’exécution ailleurs dans le programme, sans condition ou seulement si la dernière comparaison a donné un certain résultat ; une variante mémorise l’adresse de départ pour pouvoir y revenir ensuite, ce qui permet d’écrire des sous-programmes.
Opérations de base (suite)
Les processeurs récents ajoutent des instructions plus puissantes, qui remplacent chacune une longue suite d’instructions simples : multiplication et division, calcul sur les nombres flottants (racine carrée, sinus…), copie d’un grand bloc de mémoire, ou même la même opération appliquée d’un coup à plusieurs valeurs.
Enfin, un programme en assembleur ne contient pas que des instructions. On peut y donner un nom à une ligne (une étiquette, utile comme destination d’un saut), réserver de la place pour des données ou donner un nom à une constante : l’assembleur remplace lui-même ces noms par les adresses ou les valeurs correspondantes, ce qui rend le programme plus lisible.
Le langage assembleur
Une suite de 0 et de 1 est très difficile à écrire et à relire sans se tromper. On a donc donné à chaque code d’opération un nom court et facile à retenir, un mnémonique : ADD pour additionner, SUB pour soustraire, MOV pour placer une valeur, LDR pour lire en mémoire… Les registres s’écrivent R0, R1, R2… C’est le langage assembleur. L’instruction binaire de notre processeur imaginaire devient par exemple :
ADD R2, R2, #10
Le langage assembleur (suite)
On lit : « ajouter 10 au contenu du registre R2, et ranger le résultat dans R2 ». Le symbole # signale une valeur écrite directement dans l’instruction, et non une adresse.
Voici un court programme en assembleur : il lit deux nombres au clavier, les additionne, puis affiche le résultat.
  INP R0, 2
  INP R1, 2
  ADD R2, R0, R1
  OUT R2, 4
  HALT
Le langage assembleur (suite)
Pour que le processeur puisse l’exécuter, ce texte doit être traduit en langage machine. Cette traduction est faite par un programme appelé lui aussi assembleur : chaque mnémonique est remplacé par son code binaire, chaque registre et chaque valeur par leur codage. La traduction est presque mot à mot : à une ligne d’assembleur correspond, en général, une instruction machine.
Le langage assembleur (suite)
En résumé :
- le langage machine est la suite de bits que le processeur exécute directement ;
- le langage assembleur écrit les mêmes instructions avec des noms lisibles par un humain ;
- l’assembleur (le programme) traduit le langage assembleur en langage machine.
Remarques :
Le langage assembleur (suite)
- Comme le langage machine, un langage assembleur est propre à une famille de processeurs. Le simulateur AQA a le sien ; la fiche d’exercices utilise celui d’un vrai processeur, le MIPS : mêmes idées, mais d’autres noms (
li $t0, 10au lieu deMOV R0, #10). - On dit que c’est un langage de bas niveau : chaque ligne correspond à une opération élémentaire du processeur.
Les compilateurs / interpréteurs
Écrire un programme entier en assembleur reste long et fastidieux. On a donc créé des langages de haut niveau (C, Python, JavaScript…), dont les instructions ressemblent davantage à des phrases ou à des formules mathématiques.
Les compilateurs / interpréteurs (suite)
Un langage est dit de haut niveau quand il éloigne le programmeur des détails de la machine : il manipule des variables, des listes ou des fonctions, et non des registres ou des adresses. À l’inverse, un langage de bas niveau comme l’assembleur colle au fonctionnement du processeur. On parle de niveau d’abstraction du langage.
Les compilateurs / interpréteurs (suite)
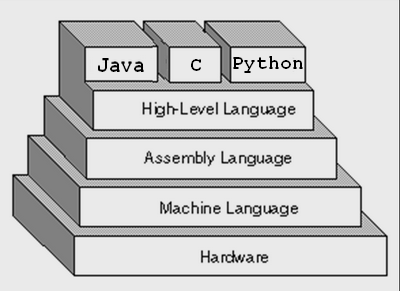
Figure 1 : Abstraction du langage
Les compilateurs / interpréteurs (suite)
Le processeur, lui, ne comprend que son langage machine. Tout programme doit donc être traduit avant ou pendant son exécution.
Les compilateurs / interpréteurs (suite)
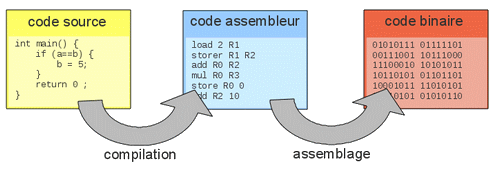
Figure 2 : Compilation interprétation
Les compilateurs / interpréteurs (suite)
Trois façons de faire existent :
- la compilation : un programme appelé compilateur traduit une fois pour toutes le programme complet et produit un fichier exécutable en langage machine ; on peut ensuite lancer ce fichier autant de fois qu’on le veut sans retraduire. Le langage C fonctionne ainsi ;
- l’interprétation : un programme appelé interpréteur lit le programme instruction par instruction, traduit chacune et l’exécute aussitôt ; la traduction est refaite à chaque lancement. Les premières versions du langage Basic fonctionnaient ainsi ;
Les compilateurs / interpréteurs (suite)
- la méthode mixte : le programme est d’abord traduit en un code intermédiaire, le bytecode, qui n’est le langage d’aucun processeur réel. Ce bytecode est ensuite exécuté par une machine virtuelle, un programme qui joue le rôle d’un processeur. Le même bytecode tourne donc sur n’importe quel ordinateur qui possède la machine virtuelle adaptée. Python et Java utilisent cette méthode.
L’assembleur, en pratique
Le simulateur AQA
Pour voir un processeur au travail, nous utilisons le simulateur AQA , écrit par Peter Higginson et utilisable directement dans un navigateur. Il représente une machine de Von Neumann simplifiée, que l’on programme en assembleur.
Deux règles changent tout par rapport à Python :
- il n’y a pas de variables : une valeur est rangée soit dans l’un des treize registres
R0àR12, soit dans un mot de la mémoire, désigné par son adresse ; - le processeur ne calcule qu’avec des registres : une valeur rangée en mémoire doit d’abord être chargée dans un registre avant d’être utilisée dans un calcul.
Le simulateur AQA (suite)
L’écran du simulateur comporte trois colonnes.
- À gauche, le programme. On écrit le programme en assembleur, on le valide avec le bouton Submit, qui le traduit en langage machine et le range dans la mémoire, puis on le lance avec Run. Le bouton Step exécute une seule instruction à la fois, et le menu OPTIONS règle la vitesse d’exécution.
Le simulateur AQA (suite)
- Au centre, le processeur. On y voit :
- les registres
R0àR12, qui contiennent les valeurs en cours de calcul ; - le compteur de programme PC, qui contient l’adresse de la prochaine instruction ;
- l’unité de contrôle et son registre d’instruction CIR, où est rangée l’instruction en cours de décodage ;
- l’unité arithmétique et logique (ALU en anglais, UAL en français), accompagnée de quatre indicateurs, mis à jour par la seule instruction de comparaison
CMP(une addition ou une soustraction ne les modifie pas) :Z(le résultat de la comparaison est nul),N(il est négatif),C(une retenue est apparue) etV(le résultat dépasse la capacité d’un mot) ; - les bus, tracés en bleu, qui relient le processeur et la mémoire ;
- deux registres d’échange avec la mémoire : MAR reçoit l’adresse du mot à lire ou à écrire, MBR la valeur lue ou à écrire.
- les registres
Le simulateur AQA (suite)
- À droite, la mémoire. Elle est formée de mots de 32 bits, numérotés à partir de 0. Le menu OPTIONS permet d’afficher leur contenu en décimal, en binaire ou en hexadécimal.
Remarque : l’assembleur ne connaît ni « if… else », ni boucle « while » ou « for ». On les fabrique avec des sauts : un saut conditionnel s’exécute ou non selon le résultat de la dernière comparaison. La destination d’un saut est désignée par une étiquette, un nom placé devant la ligne visée.
AQA et le modèle de Von Neumann
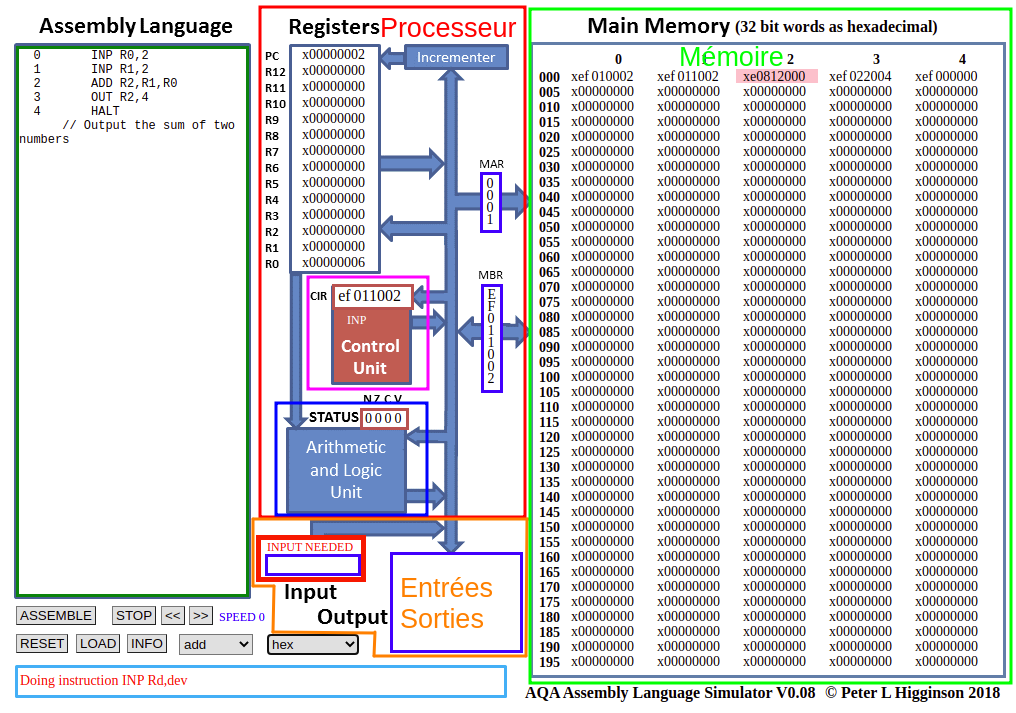
Sur la capture ci-dessous, les quatre éléments de l’architecture de Von Neumann sont encadrés :
AQA et le modèle de Von Neumann (suite)
Légende des encadrements :
- en rouge, le processeur (CPU), qui comprend :
- en rose, l’unité de contrôle (UC) ;
- en bleu, l’unité arithmétique et logique (UAL) ;
- en vert, la mémoire vive (RAM).
Mon premier programme en assembleur
La liste complète des instructions se trouve dans la documentation du simulateur , en anglais. Dans une instruction, les opérandes s’écrivent de trois façons :
Rndésigne le registre numéro n ;#ndésigne la valeur n elle-même, écrite dans l’instruction ;ndésigne le mot de la mémoire d’adresse n.
Mon premier programme en assembleur (suite)
Les instructions dont nous aurons besoin :
| Instruction | Effet |
|---|---|
MOV R1, #25 |
met la valeur 25 dans R1 |
MOV R1, R4 |
recopie dans R1 le contenu de R4 |
LDR R1, 20 |
lit le mot d’adresse 20 et le copie dans R1 |
LDR R1, [R2] |
lit le mot dont l’adresse se trouve dans R2, et le copie dans R1 |
STR R1, 22 |
écrit le contenu de R1 dans le mot d’adresse 22 |
ADD R3, R1, R2 |
calcule R1 + R2 et range le résultat dans R3 ; le dernier opérande peut aussi être #n |
SUB R3, R1, #1 |
calcule R1 − 1 et range le résultat dans R3 |
Mon premier programme en assembleur (suite)
| Instruction | Effet |
|---|---|
CMP R1, #0 |
compare R1 à 0 et met à jour les indicateurs, sans rien ranger |
BGT etiquette |
saute à l’étiquette si la dernière comparaison a donné « strictement plus grand » |
OUT R1, 4 |
affiche le contenu de R1 dans la zone de sortie |
INP R1, 2 |
attend qu’un nombre soit saisi au clavier, puis le range dans R1 |
HALT |
arrête le programme ; sans cette ligne, le processeur continuerait à lire la mémoire |
Mon premier programme en assembleur (suite)
-
Ouvrir le simulateur AQA .
-
Saisir le programme ci-dessous, puis le valider avec Submit.
MOV R0, #25 MOV R1, #17 ADD R2, R0, R1 OUT R2, 4 HALT -
Choisir l’affichage hexadécimal de la mémoire dans OPTIONS.
-
Déterminer la taille d’un mot de la mémoire et d’un registre.
Mon premier programme en assembleur (suite)
-
Observer que :
- les cinq instructions (lignes 0 à 4) occupent les mots d’adresses 0 à 4 de la mémoire ;
- les registres valent tous 0 avant l’exécution.
-
Repérer à l’écran :
- l’unité de contrôle (UC), qui décode l’instruction en cours ;
- l’unité arithmétique et logique (UAL), qui reçoit deux opérandes et produit le résultat du calcul ;
- le compteur de programme (PC), qui contient l’adresse de la prochaine instruction à lire ;
- la zone de saisie au clavier (input) ;
- la zone d’affichage (output).
Mon premier programme en assembleur (suite)
-
Exécuter le programme instruction par instruction avec Step, en vitesse lente (dans OPTIONS, choisir une vitesse lente). Recommencer autant de fois que nécessaire pour suivre chaque étape.
-
Décrire par écrit les opérations élémentaires réalisées pour chaque instruction.
-
Pour chaque ligne, décrire le rôle du PC, de l’UC, de la RAM, de l’UAL et des registres, dans l’état avant l’exécution de la ligne étudiée : pour la ligne 0, on décrit donc l’état initial.
-
Résumer ces observations dans le tableau suivant, à compléter :
Mon premier programme en assembleur (suite)
Calculer avec des données rangées en mémoire
-
Saisir le programme ci-dessous, puis le valider avec Submit.
   LDR R0, 20
   LDR R1, 21
   SUB R2, R0, R1
   STR R2, 22
   HALT
Calculer avec des données rangées en mémoire (suite)
-
Repasser l’affichage de la mémoire en décimal (OPTIONS, puis signed) : une valeur saisie est lue dans le format affiché, et « 50 » vaudrait 80 en hexadécimal. Avant de lancer le programme, écrire la valeur 50 dans le mot d’adresse 20 et la valeur 8 dans le mot d’adresse 21 : cliquer sur le mot dans la mémoire, taper la valeur, puis appuyer sur Entrée.
-
Décrire par écrit les opérations élémentaires réalisées pour chaque instruction.
-
Où se trouve le résultat de la soustraction, et que vaut-il ?
Une boucle en assembleur
Le programme suivant utilise une étiquette, boucle, et un saut conditionnel BGT.
         MOV R0, #5
boucle:  OUT R0, 4
         SUB R0, R0, #1
         CMP R0, #0
         BGT boucle
         HALT
Une boucle en assembleur (suite)
- Sans l’exécuter, prévoir ce que le programme affiche.
- Vérifier la prévision dans le simulateur.
- Écrire un programme Python qui produit le même affichage. Quelle construction de Python joue le rôle du saut
BGT boucle?
Entrées - sorties en assembleur
Dans le menu « SELECT », choisir le programme d’exemple « add » : il se charge dans la zone d’édition.
Rappel : chaque instruction
INPmet le programme en pause. L’exécution ne reprend que lorsqu’un nombre a été tapé dans la zone Input et validé avec la touche Entrée. Si rien n’est saisi, le programme reste bloqué sur cette ligne : ce n’est pas une erreur.
- Quelles instructions nouvelles ce programme utilise-t-il ?
- Décrire précisément, ligne par ligne, ce que fait ce programme d’addition.
Usage du langage assembleur
Aujourd’hui, presque plus personne n’écrit un logiciel entier en assembleur. Les compilateurs modernes produisent un code machine très efficace, souvent aussi rapide que celui qu’écrirait un spécialiste, et un programme en langage de haut niveau est bien plus rapide à écrire, à relire et à corriger.
Usage du langage assembleur (suite)
L’assembleur reste pourtant utile dans quelques situations précises :
- certaines parties du système d’exploitation : au démarrage de l’ordinateur ou lors du passage d’une tâche à une autre, le système doit utiliser des instructions particulières du processeur qu’aucun langage de haut niveau ne sait produire. On écrit alors un court sous-programme en assembleur, appelé depuis un programme en C ;
- les calculs les plus exigeants : pour certaines bibliothèques de calcul ou de traitement d’images et de son, on écrit à la main les quelques boucles qui consomment le plus de temps, afin d’exploiter au mieux les instructions spéciales du processeur ;
Usage du langage assembleur (suite)
- les petits systèmes embarqués : un microcontrôleur est un petit processeur avec sa mémoire, intégré à un appareil (télécommande, thermostat, jouet…). Les plus modestes disposent de très peu de mémoire : le PIC 16F84 n’accepte que 1024 instructions et ne possède que 68 octets de mémoire vive. Chaque octet compte, et l’assembleur permet d’en tirer le meilleur parti. Comme ces composants deviennent plus puissants pour le même prix, on les programme toutefois de plus en plus en C ;
Usage du langage assembleur (suite)
- la compréhension et la mise au point : la plupart des compilateurs peuvent afficher le code assembleur qu’ils produisent. Le lire aide à comprendre ce que fait réellement la machine, à trouver certains bogues ou à repérer la partie d’un programme qui le ralentit.
En dehors de ces cas, l’assembleur coûte trop cher : le programmeur doit tout gérer lui-même (chaque registre, chaque adresse, chaque saut), le programme est long, difficile à relire, et il ne fonctionne que sur un seul type de processeur.
Résumé en vidéo
Que retenir ?
A minima…
- Un programme rangé en mémoire est une suite d’instructions machine, que le processeur exécute directement.
- Une instruction machine se compose d’un code d’opération et d’opérandes ; les opérandes peuvent être des valeurs, des registres ou des adresses en mémoire.
- Le langage assembleur écrit ces instructions avec des noms lisibles (
MOV,ADD,LDR…) ; le programme assembleur les traduit en langage machine, presque ligne pour ligne.
A minima… (suite)
- Chaque famille de processeurs a son propre jeu d’instructions, limité à des opérations simples : transfert, calcul, comparaison, saut.
- Un compilateur traduit un programme écrit en langage de haut niveau, comme C, en langage machine. Python, lui, est traduit en bytecode, exécuté par une machine virtuelle.
Au mieux…
- L’unité de contrôle lit l’instruction désignée par le compteur de programme, puis la décode :
- les premiers bits donnent le code de l’opération (
MOV,ADD,STR…), qui commande le travail de l’UAL ; - les bits suivants donnent les opérandes : une valeur s’écrit
#n, un registreRn, une adresse en mémoiren.
- les premiers bits donnent le code de l’opération (
- Écrire en assembleur des programmes très simples : calcul, lecture et écriture en mémoire, boucle avec un saut.
- Suivre, dans un simulateur comme AQA, l’exécution d’un programme simple et le rôle de chaque composant.